
昨天簡單介紹了資料結構與演算法,提到同一份資料可用不同方式組織,而不同的資料結構與解決步驟也可能產生不同的運算成本,不過當我們說某個方法「比較有效率」時,到底是怎麼判斷的呢?
最直覺的方式大概是直接執行兩段程式、看看它們各自花了多少時間,假設演算法 A 執行了 1 ms、演算法 B 執行了 3 ms,那應該就能說 A 比較快了吧?但這個數字到底能代表多少事情,其實比想像中複雜一點🤏🏻。今天就從這個問題出發,介紹描述演算法成本的常見工具:Big O。
1 ms 這個數字確實能告訴我們一件事,也就是在這次測試使用的環境與輸入資料下,演算法 A 的執行時間比較短。但它還不足以證明演算法 A 在其他電腦、其他輸入資料,或資料量大幅增加後,仍然一定比較快。
程式的實際執行時間除了受到輸入資料影響,也會受到電腦硬體、JavaScript 引擎、JIT 編譯與當下系統負載等因素影響,即使在同一台電腦上、用相同輸入重複執行完全相同的程式,也可能得到略有不同的結果。另外,一個方法在處理 10 筆資料時比較快,也不代表資料增加到 10 萬筆後,它仍然會是比較快的選擇。
不過執行時間也不是完全沒有規律可循,這裡的關鍵在於不穩定的是「絕對數字」,而「數字之間的關係」其實是穩定的。
假設我們有一個需要逐一走訪所有訂單的函式,讓它分別處理 1000 萬、2000 萬與 3000 萬筆訂單,並在兩個不同的 JavaScript 執行環境下各測一次:
| 訂單數量 | 環境 A(Node.js / V8) | 環境 B(JavaScriptCore) |
|---|---|---|
| 1000 萬 | 74.1 ms | 15.8 ms |
| 2000 萬 | 147.5 ms | 31.1 ms |
| 3000 萬 | 224.0 ms | 45.5 ms |
同一段程式、同一份輸入、同一台電腦,只是換了 JavaScript 引擎,絕對耗時就差了將近五倍,如果只拿其中一欄的數字出來,我們沒辦法用它描述另一個環境的表現,但若改看每個環境「自己」的變化:
| 訂單數量 | 環境 A(相對 1000 萬筆) | 環境 B(相對 1000 萬筆) |
|---|---|---|
| 1000 萬 | 1.00 倍 | 1.00 倍 |
| 2000 萬 | 1.99 倍 | 1.97 倍 |
| 3000 萬 | 3.02 倍 | 2.88 倍 |
兩個環境的絕對速度差了快五倍,但「資料量變成兩倍,時間也大約變成兩倍」這件事,在兩邊都成立。
補充:上面的數字怎麼測的
測試環境為 Apple M1(8 核、16GB RAM),環境 A 是 Node.js v24.14.0(V8 引擎),環境 B 是 macOS 內建的 JavaScriptCore(Safari 使用的引擎,可透過
/System/Library/Frameworks/JavaScriptCore.framework/Versions/Current/Helpers/jsc執行)。兩邊跑的是相同的檔案,訂單資料以固定亂數種子產生、確保兩個引擎拿到同一份輸入,每個資料量先暖機 3 次讓 JIT 完成最佳化,再正式測量 7 次並取中位數。
可注意到環境 B 的 3000 萬筆是 2.88 倍而不是 3.00 倍。這種程度的誤差在實際測量中很正常,可能來自 GC、記憶體配置或 cache miss,這也剛好說明為什麼我們需要大致的成長趨勢,而不是精確數字。
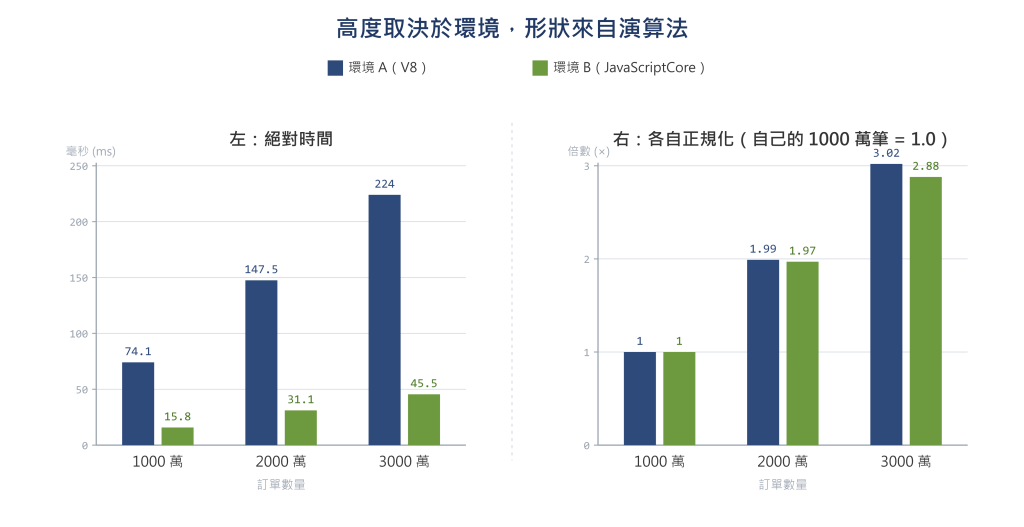
圖 1 高度取決於環境,形狀來自演算法
換句話說:
Big O 想描述的就是後者,它不會告訴我們程式會跑幾毫秒,而是回答「當輸入變大時,成本會以什麼方式跟著變大」。
另外,其實我們不需要真的把程式跑過一遍才能知道這個倍數關係,只要能算出「主要工作會重複幾次」,就可以在測量以前先預測它的成長方式。
在演算法分析中通常會使用 N 代表輸入規模(Input Size),而根據問題不同,N 可能代表 Array 中的元素數量、字串的字元數量、Tree 中的 Node 數量,或 Graph 中的 Vertex 與 Edge 數量。(這裡的專有名詞 Graph、Vertex 和 Edge 等看不懂沒關係,可簡單將 N 想為輸入規模即可。)
因此,在分析一個演算法以前,我們必須先釐清:
對目前這個問題來說,什麼東西的數量正在增加?
接著要找出程式中的主要操作,程式的一次迴圈可能同時包含資料讀取、條件比較、變數更新與函式呼叫等多個操作,例如以下就包含了資料讀取、條件比較、變數更新:
for (const order of orders) {
  if (order.needsReview) {
    reviewCount += 1;
  }
}
若要精確計算 CPU 實際執行了多少指令,還會牽涉程式語言、JavaScript 引擎、編譯器最佳化與硬體實作等細節,所以為了讓分析保持簡單且通用,在初步分析演算法時,通常會先講好一組簡化的規則:哪些動作算是一個基本操作、這些操作各自花多少時間與空間,而整個演算法的成本就是所有操作成本的總和。這組事先講好的規則,稱為 Model of Computation(計算模型)。
有了這前提,我們就不需精確計算每個 CPU 指令,而是把每一輪中固定數量的基本操作視為固定成本,再觀察這段工作會隨著輸入規模重複幾次。
假設現在有一組訂單資料,我們想計算其中有多少筆訂單需要人工審核:
function countOrdersNeedingReview(orders) {
  let reviewCount = 0;

  for (const order of orders) {
    if (order.needsReview) {
      reviewCount += 1;
    }
  }

  return reviewCount;
}
在這個問題中 N 代表訂單數量,而主要操作是「檢查一筆訂單是否需要人工審核」,由於每一筆訂單都需要被檢查一次,如果有 10 筆訂單就需要檢查 10 次,若有 1000 筆訂單,就需要檢查 1000 次。
| 訂單數量 | 檢查次數 |
|---|---|
| 10 | 10 |
| 100 | 100 |
| 1000 | 1000 |
從表格可看出,當訂單數量增加 10 倍時,檢查次數也會跟著增加 10 倍。比起只說「這個函式處理 100 筆訂單時花了 0.5 毫秒」,我們可以用更通用的方式描述:「如果有 N 筆訂單,程式就需要進行大約 N 次檢查。」
這個描述不再只適用於某一次執行,而是能說明輸入規模改變時,運算成本會如何跟著改變。
Big O 是一種用來描述輸入規模增加時、演算法所需成本如何成長的表示方式,它關心的不是某次執行的精確毫秒數,也不一定是精確的操作次數,而是:
當輸入規模
N持續增加時,成本會以什麼方式成長?
順帶說明一下這個符號的由來,Big O 的 O 取自德文的 Ordnung(order,量級),也就是我們常說的 Order of Growth(成長的量級)。它原本是 19 世紀數學家用來描述函數成長率的符號,後來才被廣泛用於演算法分析。
知道 O 代表「量級」之後,來看看 O(N) 是什麼意思,O(N) 的意思是「這做法的成本,成長量級和 N 相同」,而不是「這個做法會執行剛好 N 個步驟」。
在前面的訂單範例中,如果輸入有 N 筆訂單,程式就需要逐一檢查 N 筆資料,操作次數會隨著 N 呈線性增加,因此可以表示為 O(N)。
這裡的 O(N) 並不是表示程式永遠剛好執行 N 個 CPU 指令,而是表示輸入規模增加幾倍,主要工作量也會大致增加相同的倍數。
簡言之,看到一段程式時,我們可以先思考三個問題:
以前面的訂單範例來說,輸入規模是訂單數量 N,主要操作是檢查一筆訂單,總共會執行 N 次,因此成本會呈現線性成長,可以表示為 O(N)。
補充:Big O 的數學意義
更正式地說,Big O 描述的是函數成長率的「漸近上界」:當輸入規模大到一定程度後,演算法成本不會超過某種成長方式的固定倍數。
O(N)可以想成一個集合,包含成長得比N慢或差不多的函數,像3N + 2與0.5N都屬於O(N)。因此3N + 2 = O(N)中的等號,意思其實比較接近「屬於」。同一個函數也可以屬於多個集合,例如3N + 2也屬於O(N²),只是這樣的描述比較寬鬆。嚴格的數學表示還會區分
O(漸近上界)、Ω(漸近下界)與Θ(漸近緊確界)。如果某段程式的操作次數是3N + 2,更精確的寫法是Θ(N);不過在工程實務與演算法教材中,通常仍會直接用 Big O 表示主要的成長級別,本文也會沿用這種常見寫法。
接下來先介紹幾種在後續文章中會經常出現的時間複雜度:
O(1)
O(log N)
O(N)
O(N²)
O(1):成本不隨輸入規模增加O(1) 又稱為 Constant Time(常數時間),表示操作數量不會隨著輸入規模 N 增加。
例如,取得第一筆訂單:
function getFirstOrder(orders) {
  return orders[0];
}
在一般 Array 隨機存取的成本模型下,無論 orders 中有 10 筆、1000 筆或 100 萬筆訂單,程式都可以直接透過 index 0 取得第一個元素,不需要逐一檢查其他資料,因此這個操作可以表示為 O(1)。
這裡的 1 表示的是操作數量不會隨輸入規模增加,並不是指程式一定只執行一個 CPU 指令。
例如,下面的函式固定取得第一筆訂單、最後一筆訂單與訂單總數:
function getOrderSummary(orders) {
  const firstOrder = orders[0];
  const lastOrder = orders[orders.length - 1];
  const total = orders.length;

  return {
    firstOrder,
    lastOrder,
    total,
  };
}
即使這個函式不只執行一項操作,但不論 orders 的長度是多少,需要執行的主要操作數量都不會跟著增加,因此仍然屬於 O(1)。
至於 Array 為什麼能透過 index 快速取得元素,會留到後面的 Array 文章再詳細說明。
O(log N):每次縮小問題規模O(log N) 又稱為 Logarithmic Time(對數時間),這類演算法不需要逐一處理全部資料,而是每執行一次就將剩餘的問題縮小一部分,最常見的情況是每次縮小為原本的一半。
假設現在要舉辦一場單淘汰賽,每一輪結束後落敗的選手會被淘汰,因此剩餘選手數量大約會減少一半。
如果一開始有 64 位選手,每一輪過後剩餘的人數會是:
64  →  32  →  16  →   8  →   4  →   2  →   1
      第1輪  第2輪  第3輪   第4輪   第5輪  第6輪
雖然一開始有 64 位選手,但只需要進行六輪就能得到最後一位勝出者,而如果參賽人數增加一倍變成 128 位,過程則會變成:
128 → 64 → 32 → 16 → 8 → 4 → 2 → 1
參賽人數雖然增加了一倍,卻只需要比原本多進行一輪,這是因為每經過一輪剩餘人數都會減少一半,所以輸入規模即使增加很多,需要增加的輪數仍然很少。
可以使用以下程式計算需要進行幾輪比賽:
function countTournamentRounds(playerCount) {
  let remainingPlayers = playerCount;
  let rounds = 0;

  while (remainingPlayers > 1) {
    remainingPlayers = Math.ceil(remainingPlayers / 2);
    rounds += 1;
  }

  return rounds;
}

countTournamentRounds(8); // 3
countTournamentRounds(64); // 6
countTournamentRounds(1024); // 10
每一輪都會將 remainingPlayers 縮小到大約一半,因此迴圈不需要執行 N 次,即使參賽人數從 8 位增加到 1024 位、也就是增加了 128 倍,需要進行的輪數仍然只從 3 輪增加到 10 輪。
這種「輸入規模增加很多,但操作次數只緩慢增加」的成長方式,可以表示為 O(log N)。
在這個例子中每次都是除以 2,因此輪數正好是 log₂N,不過不同底數的對數只會相差一個固定倍數,因此在 Big O 中通常會省略對數的底數,統一寫成 O(log N)。
小補充一點,這裡分析的是「淘汰賽需要進行幾輪」,若分析的是整場賽事總共需要舉行多少場比賽,單淘汰賽則需要進行 N - 1 場、屬於 O(N),同一個情境可能因為分析的操作不同,而得到不同的時間複雜度,所以在判斷 Big O 以前,要先確認我們正在計算哪一項工作。
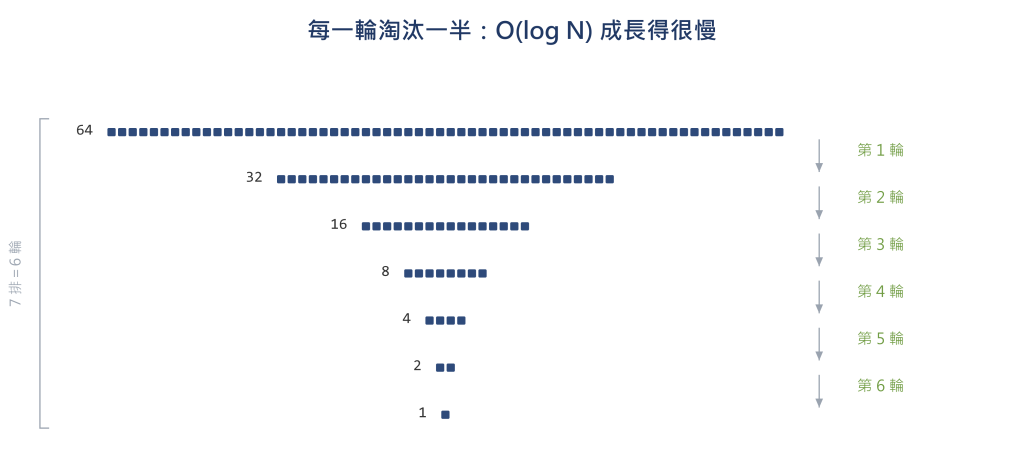
圖 2 每一輪淘汰一半
O(N):成本與輸入一起成長O(N) 又稱為 Linear Time(線性時間),前面用來說明「輸入規模與操作次數」的 countOrdersNeedingReview 就是個例子,必須從第一筆訂單逐一檢查到最後一筆,N 筆訂單就檢查 N 次。
只要程式需要「完整走過輸入一次」,例如加總、篩選、找最大值或列印全部資料,通常都會落在 O(N)。
O(N²):資料之間需要成對比較如果每一筆資料都需要和其他多筆資料進行比較,工作量就可能接近 N × N。
假設電商系統偶爾會因為使用者重複點擊付款按鈕,在短時間內產生內容相同的訂單,為了找出可能重複成立的訂單,我們需要比較每一組訂單:
function compareEveryOrderPair(orders) {
  for (let i = 0; i < orders.length; i++) {
    for (let j = i + 1; j < orders.length; j++) {
      // compareOrders 會檢查兩筆訂單的使用者、金額與成立時間是否相近,
      // 檢查的條件數量固定,不會隨訂單總數改變
      compareOrders(orders[i], orders[j]);
    }
  }
}
外層迴圈會依序選出一筆訂單、內層迴圈則將它與後面的其他訂單進行比較,假設共有四筆訂單,實際比較順序如下:
內層迴圈從 i + 1 開始是為了避免一筆訂單和自己比較、也能避免重複檢查相同組合,例如當訂單 1 已經和訂單 2 比較過,就不需要再比較一次訂單 2 和訂單 1。
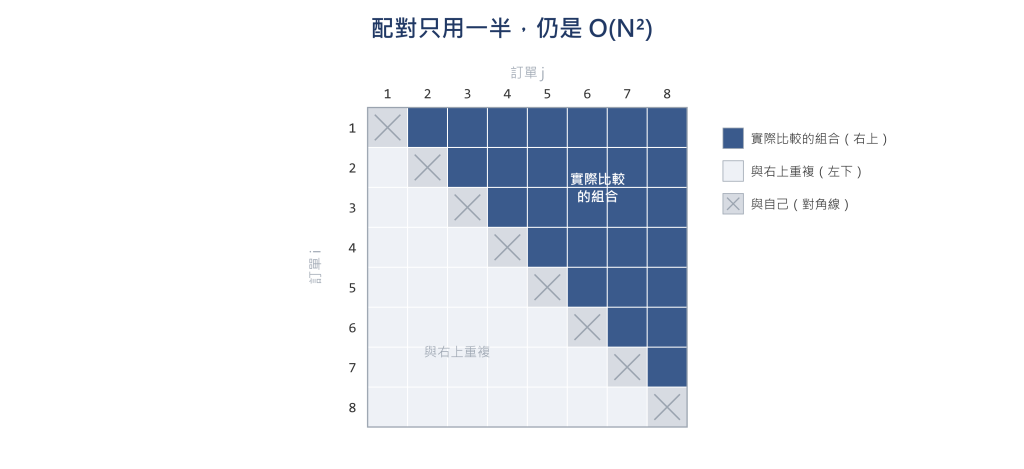
圖 3 配對只用一半,仍是 O(N²):一半仍然是 N² 的固定比例,成長級別不變
若總共有 N 筆訂單,需要比較的組合數量為 N(N-1)/2,訂單數量與執行次數的趨勢整理如下:
| 訂單數量 | 需要比較的組合數量 |
|---|---|
| 10 | 45 |
| 100 | 4,950 |
| 1000 | 499,500 |
雖然比較次數不是剛好等於 N²,但當訂單數量增加 10 倍時,需要比較的組合數量會增加到接近 100 倍。將公式展開後為 (N²-N)/2,隨著 N 持續增加,N² 會逐漸成為影響整體成本的主要部分,因此時間複雜度表示為 O(N²)。
這裡也可看到,每次比較雖然需要檢查使用者、金額與成立時間等多個條件,但只要這些條件的數量不會隨著訂單總數增加,就可以先視為每組訂單都會進行的固定工作。真正隨著輸入規模快速增加的,是需要檢查的訂單組合數量。
將前面四種複雜度放在一起比較,以下 O(log N) 欄位以每次將問題減半為例,因此列出的是 log₂N。
N |
O(1) |
log₂N |
O(N) |
O(N²) |
|---|---|---|---|---|
| 10 | 1 | 4 | 10 | 100 |
| 100 | 1 | 7 | 100 | 10,000 |
| 1000 | 1 | 10 | 1000 | 1,000,000 |
當輸入規模還很小時,不同複雜度之間的差距可能不明顯,但隨著 N 持續增加,不同成長方式造成的差距會越來越大。
把這四種成長方式畫在同一張圖上,差距會更明顯:
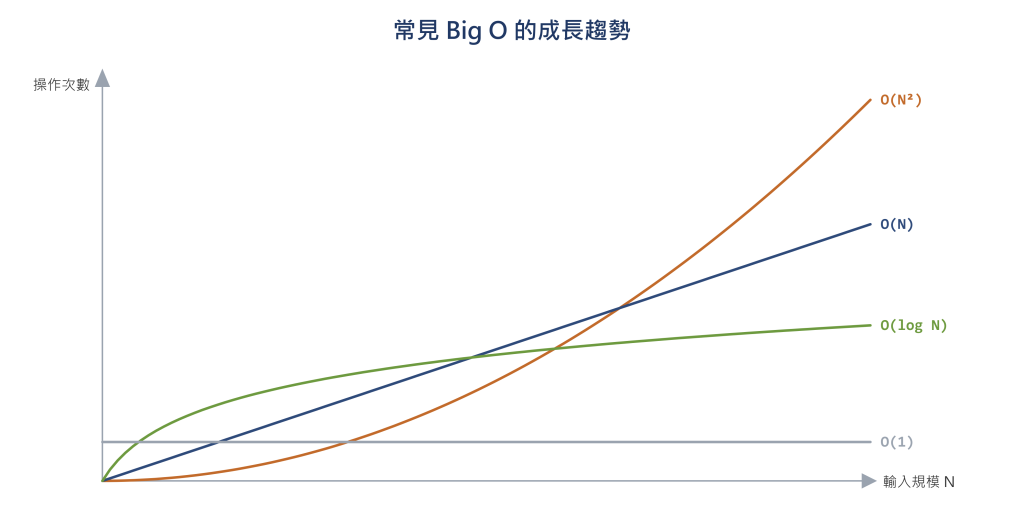
圖 4 常見 Big O 的成長趨勢,曲線只呈現相對差異
至於 O(N log N)、O(2^N) 與 O(N!) 等其他複雜度,等後續遇到相關演算法時再介紹。
看完上面那張圖很容易有個感覺,O(1) 最好、O(N²) 最糟,選好的演算法就是直接選成長曲線最平的那個,不過這其實是最常見的誤解之一,這裡稍微澄清一下~
O(1) 不代表「很快」可能有人會覺得 O(1) 就是「瞬間完成」,但其實不是這樣。
假設某個函式每次都要讀取一份固定大小的設定檔,花費 5 毫秒,而且不論輸入有 10 筆或 1000 萬筆訂單都一樣是 5 毫秒,那它仍然屬於 O(1)。反過來說,一個 O(N) 的函式在 N 只有 3 的時候,很可能比這個 O(1) 函式快上許多。
O(1) 描述的是「成本不隨輸入規模改變」而非「成本很小」,同樣地 O(N²) 也不代表「一定很慢」,只表示成本會隨輸入規模以平方的方式成長,這也是為什麼在資料量很小時,成長級別比較差的做法有時反而更實用。
實際選擇演算法時,除了成長級別,還是要一併考慮輸入規模、常數成本、空間使用量、實作難度,以及問題本身的限制。
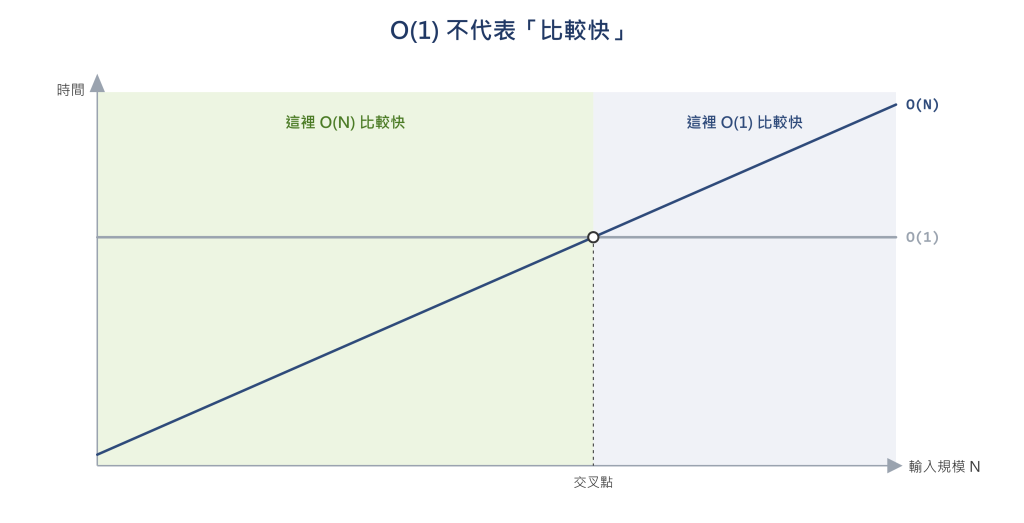
圖 5 O(1) 不代表「比較快」
複雜度描述的是「我們選擇的做法」而不是「這個問題本身」,同樣的需求,換一種做法就可能換一個成長級別。
例如,如果我們想知道目前所有訂單的總金額,最直接的做法是把每一筆訂單加總:
function getTotalRevenue(orders) {
  let total = 0;

  for (const order of orders) {
    total += order.amount;
  }

  return total;
}
這個做法必須讀完每一筆訂單,因此是 O(N)。
但如果系統在每次新增訂單時,就順手把金額累加到一個 totalRevenue 欄位上,那之後要取得總金額,只需直接讀取這欄位:
function getTotalRevenue(store) {
  return store.totalRevenue;
}
這時不論已經累積了 10 筆或 1000 萬筆訂單,取得總金額的成本都不會改變,因此是 O(1)。
不過要注意的是,成本並沒有消失,只是被搬到別的地方了,每次新增訂單時都要多做一次累加,而且一旦有人繞過這個流程直接改資料,totalRevenue 就可能和實際訂單對不起來,也就是說我們是用「寫入時多做一點事、以及維護一致性的責任」,換到「讀取時幾乎不用做事」。這種把成本從一端搬到另一端的取捨,在後續章節會不斷出現。
類似的例子在數學上也看得到:計算 1 加到 N,用迴圈累加是 O(N),但直接套用公式 N(N + 1) / 2 就是 O(1)。
所以當我們說「這是 O(N)」時,說的其實是「我們目前這個做法是 O(N)」而不是「這個問題只能用 O(N) 解決」。
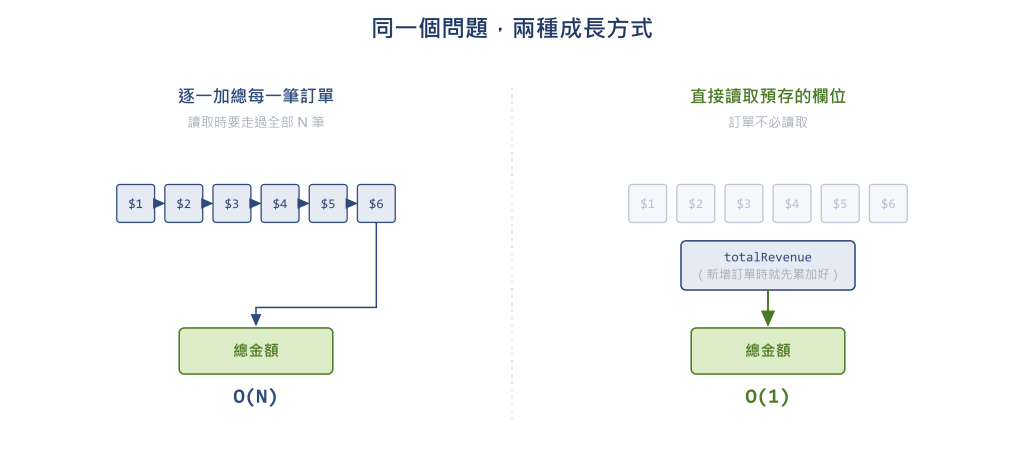
圖 6 同一個問題,兩種成長方式
分析演算法時,經常會優先討論 Worst Case(最壞情況)。
假設我們要從一組尚未排序的訂單中,根據 id 找出目標訂單:
function findOrderById(orders, targetId) {
  for (const order of orders) {
    if (order.id === targetId) {
      return order;
    }
  }

  return null;
}
如果目標訂單剛好是陣列中的第一筆就只需要檢查一次,而若目標位於最後一筆或根本不存在,就需要檢查全部 N 筆資料,因此這個函式的 Best Case 是 O(1),Worst Case 則是 O(N)。
Worst Case 可以讓我們知道在最不理想的輸入情況下,演算法最多可能需要進行多少工作,而初學演算法時若沒有特別說明,通常會優先使用 Worst Case 作為主要分析角度。
不過這裡要補充、澄清的是,Big O 並不等於 Worst Case。
Big O 是描述成長上界的數學符號;Best Case、Average Case 與 Worst Case 則是在描述不同的輸入情況。這是兩個不同維度的東西,我們可以分別分析某個演算法在 Best Case、Average Case 或 Worst Case 下的成長率,就像上面同時寫出了 O(1) 和 O(N) 一樣。
在這系列文章中,如果沒有特別說明,會先以常見的 Worst Case 作為主要分析角度。
前面提過分析時可以問自己三個問題,其中第三個「操作次數會以什麼方式成長?」通常還需要做些簡化,這裡整理幾個常用的簡化規則~
假設後台系統每天都需要產生一份訂單報表,其中包含當天所有訂單的總金額以及需要人工審核的訂單 ID,由於這兩項資料的處理目的不同,程式可能分成兩個階段:
function generateDailyOrderReport(orders) {
  let totalRevenue = 0;

  // 第一階段:計算所有訂單的總金額
  for (const order of orders) {
    totalRevenue += order.amount;
  }

  const reviewOrderIds = [];

  // 第二階段:找出需要人工審核的訂單
  for (const order of orders) {
    if (order.needsReview) {
      reviewOrderIds.push(order.id);
    }
  }

  return {
    totalRevenue,
    reviewOrderIds,
  };
}
假設 orders 中共有 N 筆訂單,第一個迴圈需要處理 N 筆資料,第二個迴圈也需要處理 N 筆資料,因此總處理次數大致為 N+N=2N。
| 訂單數量 (N) | 第一階段 | 第二階段 | 總處理次數 |
|---|---|---|---|
| 10 | 10 | 10 | 20 |
| 100 | 100 | 100 | 200 |
| 1000 | 1000 | 1000 | 2000 |
當輸入資料增加 10 倍時,總處理次數同樣增加 10 倍,有兩個迴圈並不代表它是平方級成長,因為兩個迴圈是依序執行、而不是彼此巢狀,因此 O(2N) → O(N)。
同樣地,一段需要執行 100N 次操作的程式,實際上很可能比只執行 N 次操作的程式慢。但無論操作次數是 N、2N 還是 100N,當輸入規模增加 10 倍時,工作量也都會增加約 10 倍,呈現相同的線性成長趨勢,因此在 Big O 中都會被歸類為 O(N)。
不過要注意,兩段程式依序執行時「相加」的前提是它們處理同一份輸入,若處理的是不同大小的輸入,就不能全部使用 N 表示:
function printUsersAndOrders(users, orders) {
  for (const user of users) {
    console.log(user.name);
  }

  for (const order of orders) {
    console.log(order.id);
  }
}
假設 A 代表使用者數量,B 代表訂單數量,第一個迴圈執行 A 次,第二個迴圈執行 B 次,因為我們不能直接假設使用者數量一定和訂單數量相同,所以複雜度應表示為 O(A+B)。
回頭看文章前面那兩個執行環境的測試,其實就能理解 Big O 為什麼要刻意忽略固定倍數,因為固定倍數正好是最容易被執行環境影響的部分,前面光是把 V8 換成 JavaScriptCore,這個倍數就差了快五倍;換一台電腦、換一個引擎版本,或換一種資料型別,它同樣會改變。但「輸入變兩倍、工作量也大約變兩倍」這個關係,在兩個環境下都沒有變。
因此使用 Big O 表示時,會忽略固定倍數,只保留輸入規模增加時最主要的成長趨勢。
當然,忽略固定倍數不代表固定倍數對實際執行成本沒有影響。完整走訪兩次訂單,通常仍然會比只走訪一次進行更多工作,如果能將兩項工作合併到同一個迴圈,也可能減少部分實際成本。
假設某個演算法的操作次數可以表示為 N²+N+10,當 N 很小時,N 與常數 10 仍然可能看得出影響;但隨著 N 持續增加,N² 會逐漸成為主要成本。
N |
N² |
N |
常數 |
|---|---|---|---|
| 10 | 100 | 10 | 10 |
| 100 | 10,000 | 100 | 10 |
| 1000 | 1,000,000 | 1000 | 10 |
因此,使用 Big O 表示時,會保留成長最快的項目:
O(N²+N+10) → O(N²)
這個對整體成本影響最大的項目,通常稱為 Dominant Term(主導項)。
假設一個迴圈包在另一個迴圈內,而且兩層都完整走訪同一份輸入:
for (const firstOrder of orders) {
  for (const secondOrder of orders) {
    // ...
  }
}
外層迴圈執行 N 次,而外層每執行一次,內層迴圈都會再完整執行 N 次,因此總次數為 N × N=N²,時間複雜度為 O(N²)。
不過,不能只看到巢狀迴圈就直接判定是 O(N²)。例如以下範例:
for (let i = 1; i < n; i *= 2) {
  for (let j = 0; j < n; j++) {
    // ...
  }
}
外層迴圈每次將 i 乘以 2,因此只執行大約 log N 次;內層每次執行 N 次,總成本為 O(N log N)。
因此,巢狀結構通常需要將各層的執行次數相乘,但仍然要根據每一層真正的迴圈條件進行分析,不能只看到程式語法就直接套用公式。
以下整理幾個常見情況:
| 程式結構 | 成本計算 |
|---|---|
| 相同輸入完整走訪兩次 | O(N+N) → O(N) |
| 不同輸入分別走訪 | O(A+B) |
每個 A 元素都完整走訪 B |
O(A × B) |
兩層都完整走訪大小為 N 的輸入 |
O(N²) |
| 忽略固定倍數 | O(2N) → O(N) |
| 保留主導項 | O(N²+N) → O(N²) |
看過簡化規則後,來試著自己計算看看 Big O 吧~
假設有以下函式,它會列出所有商店名稱,並統計商店與訂單的配對數量:
function summarizeStores(stores, orders) {
  const storeNames = [];

  for (const store of stores) {
    storeNames.push(store.name);
  }

  let matchedCount = 0;

  for (const store of stores) {
    for (const order of orders) {
      if (order.storeId === store.id) {
        matchedCount += 1;
      }
    }
  }

  return { storeNames, matchedCount };
}
依照前面的三個問題一步步拆解:
對這個問題來說,輸入規模是什麼?
這裡有兩份會各自變動的輸入,因此不能都用 N 表示。用 S 代表商店數量,R 代表訂單數量。
當輸入規模增加時,主要操作會執行幾次?
stores 一次 → S 次orders,依照「巢狀相乘」→ S × R 次S + S × R 次操作次數會以什麼方式成長?
先寫出 O(S + S × R),再保留主導項。因為訂單數量 R 至少是 1,S × R 一定不會小於 S,所以 S × R 是這裡的 Dominant Term,最後可以簡化為 O(S × R)。
補充一個延伸情況:如果這個系統的商店數量是固定的(例如永遠只有 5 家),那 S 就只是一個常數、不再是會成長的輸入規模,此時複雜度會變成 O(R)。這也再次呼應第一個問題的重要性——要先確認「什麼東西的數量正在增加」,答案才會正確。
Big O 是很實用的分析工具,但它不是判斷程式好壞的唯一標準。它有一些看不到、無法描述或衡量的部分。
1. 它看不到固定倍數與單次操作的實際成本。 兩個演算法即使具有相同的 Big O,實際工作量仍可能因操作內容與固定倍數而相差很多。
2. 它看不到程式是否正確。 一段程式即使時間複雜度很好,如果算出的結果是錯的,就沒有實際價值。
3. 它看不到這些操作能不能同時進行。
假設我們要從 8 筆訂單中找出金額最低的那一筆。最直覺的做法是從頭掃到尾,一路記住目前看過最小的金額:
function findMinAmount(orders) {
  let minAmount = orders[0].amount;

  for (const order of orders) {
    if (order.amount < minAmount) {
      minAmount = order.amount;
    }
  }

  return minAmount;
}
8 筆訂單需要比較 7 次。
但還有另一種做法,形狀和前面的單淘汰賽一樣:先把 8 筆訂單兩兩配對比較,金額較小的那筆「晉級」;接著 4 筆再兩兩比較,然後 2 筆,最後留下的就是最小值。
第 1 輪:8 → 4    (4 場比較)
第 2 輪:4 → 2    (2 場比較)
第 3 輪:2 → 1    (1 場比較)
總共也是 4 + 2 + 1 = 7 次比較。兩種做法的比較次數完全相同,時間複雜度也都是 O(N)。
那它們有什麼差別?差別在每一次比較之間的依賴關係。
第一種做法的每一次比較都必須先知道上一次比較之後 minAmount 變成多少,所以只能一次做一個,7 次比較就是 7 個步驟;第二種做法則不同,同一輪裡的比較彼此完全獨立,第 1 輪那 4 場誰先誰後都沒關係。如果電腦有 4 顆 CPU,第 1 輪就可以同時跑完,整個過程只需 3 個步驟。
O(N) 完全看不出這件事。兩段同樣是 O(N)、操作次數也一模一樣的程式,可能一個只能排隊做,一個可以攤開來同時做。
而且不同平台在意的東西也不一樣,在分散式系統上把計算切給很多節點可以降低單一節點的負荷,但要付出資料傳輸的成本,反過來集中在單一節點雖然省下傳輸,單點的計算負荷就會變高。GPU 這類平台則特別適合大量而且簡單的可平行運算。這些差異 Big O 一樣無法描述。
小小總結一下今天對 Big O 的認識~
O 取自 Ordnung(量級),O(N) 說的是成長量級和 N 相同,而不是剛好執行 N 個步驟。圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術